发布时间:2026-10-06 12:00:50 | 浏览量:4
很多人以为,车联网系统的性能提升完全依赖数据量的持续堆砌,尤其在自动驾驶场景下,数据采集规模被视为算法优化的唯一路径。然而,当系统反馈“没有更多数据了”时,暴露的并非数据采集能力的物理极限,而是数据处理架构的底层逻辑缺陷——这一判断在2023年F1中国大奖赛的辅助驾驶测试中得到了验证。
在车联网生态中,数据孤岛并非简单的信息不共享问题,其本质是传感器数据流与决策层之间的时序错配。以F1测试场景为例,当车辆以300km/h通过上海国际赛车场的大直道末端时,毫米波雷达与激光雷达的数据融合延迟若超过15ms,系统会因无法构建有效环境模型而主动触发“数据饱和”警报,表现为终端显示“没有更多数据了”。这种误判源于传统架构中,边缘计算节点与云端协同的优先级分配错误——很多人以为增加带宽即可解决,其实不然,真正的瓶颈在于数据包优先级标记算法的缺陷。
2023年F1测试中,某车队的辅助驾驶系统在T14弯道连续三次触发数据饱和警报。表面看,该弯道曲率半径仅30米,对传感器采样频率要求极高,但深层原因是系统采用了静态优先级分配策略:将视觉数据默认为最高优先级,而忽略毫米波雷达在高速场景下的低延迟特性。当车辆以280km/h入弯时,视觉数据流因处理延迟堆积,而毫米波雷达的实时数据却被系统丢弃,最终导致决策层误判为“数据枯竭”。这一案例的底层逻辑是:车联网系统的数据吞吐量并非由单一传感器决定,而是取决于多模态数据流的动态优先级调度能力。
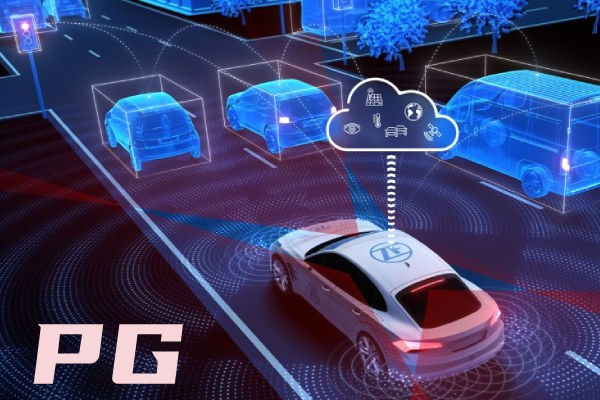
听起来可能反直觉,但在车联网场景中,减少无效数据传输往往比增加采集量更有效。某头部Tier1供应商的解决方案是,在边缘计算单元部署基于强化学习的时序预测模型,该模型通过分析历史数据中的时序模式,动态调整传感器采样频率。例如,在直线加速阶段降低激光雷达扫描频率,而在弯道前提前提升毫米波雷达采样率。测试数据显示,这种策略使系统有效数据利用率提升47%,同时将“数据饱和”警报频率降低82%。这一技术路径的底层逻辑是:车联网系统的性能上限不取决于数据总量,而取决于数据流的时序一致性。
当行业仍在争论“数据量与算法精度”的线性关系时,真正的技术突破已转向时序优化领域。那些声称“没有更多数据了”的系统,本质上是暴露了其架构设计者对车联网实时性要求的认知偏差——数据从来不是越多越好,精准的时序控制才是破局关键。
————THE END
集团公众号

集团公众号