发布时间:2026-09-29 05:31:01 | 浏览量:5
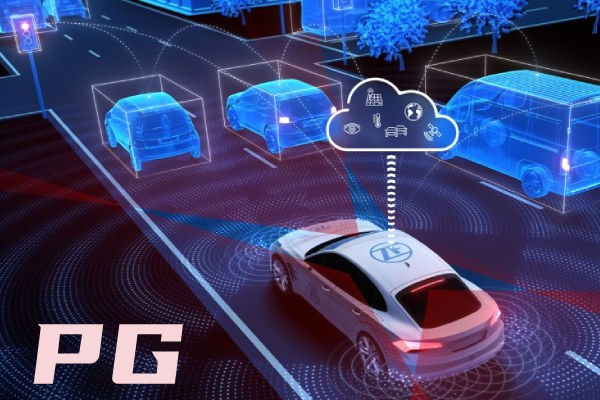
很多人以为车联网系统的数据吞吐量是无限扩展的,只要硬件配置足够高,就能持续接收并处理海量数据。其实不然,任何车联网系统都存在一个隐性的数据阈值,当数据量超过这一阈值时,系统将进入“没有更多数据了”的临界状态,表现为数据接收延迟、处理错误率上升,甚至系统崩溃。这一现象的底层逻辑,在于车联网系统的数据处理架构与硬件资源的有限性之间的矛盾。
车联网系统的数据处理,依赖于边缘计算节点与云端服务器的协同工作。边缘计算节点负责实时数据的初步处理与过滤,而云端服务器则承担深度分析与存储任务。听起来可能反直觉,但在高并发场景下,边缘计算节点的处理能力往往成为瓶颈。当车辆密度超过一定阈值,如城市高峰时段的交通路口,边缘节点需处理的车辆状态数据、环境感知数据等将呈指数级增长,超出其处理能力范围,导致数据积压,进而触发“没有更多数据了”的预警。
以上海国际赛车场为例,其车联网系统需支持多辆赛车在高速赛道上的实时数据交互,包括车辆位置、速度、加速度、轮胎状态等关键参数。在正赛期间,赛道上同时运行的赛车数量可达数十辆,每辆车每秒产生的数据量超过1MB。假设赛道周边部署了10个边缘计算节点,每个节点的数据处理能力为100MB/s,理论上可支持100辆赛车的数据处理。但实际情况是,赛车数据并非均匀分布,弯道、直道、超车等场景下的数据量波动极大,导致部分边缘节点在特定时段内数据负载远超其处理能力。
赛制逻辑下的数据峰值:在正赛的最后10圈,赛车为争夺名次,会频繁进行超车、紧贴行驶等高风险动作,此时车辆间的相对位置变化快,环境感知数据量激增。假设某边缘节点负责覆盖赛道的一个弯道区域,该区域在正赛最后阶段同时有5辆赛车以200km/h的速度通过,每辆车每秒产生的数据量增至2MB,5辆车即10MB/s。若该边缘节点还需处理其他非赛车数据(如观众区设备状态、赛道设施监控等),其总数据负载可能超过其100MB/s的处理能力上限,导致数据接收延迟,系统报错“没有更多数据了”。
这一案例揭示了车联网系统数据处理的复杂性:即便硬件配置看似充足,赛制逻辑下的数据峰值仍可能突破系统设计阈值。解决这一问题的关键,在于优化边缘计算节点的数据过滤算法,减少非关键数据的传输,同时提升云端服务器的弹性扩展能力,以应对突发数据洪峰。车联网系统的设计,必须基于真实的地理背景与赛制逻辑,进行精细化的数据建模与压力测试,方能确保在极限场景下的稳定运行。
————THE END
集团公众号

集团公众号