发布时间:2026-09-29 09:03:13 | 浏览量:2
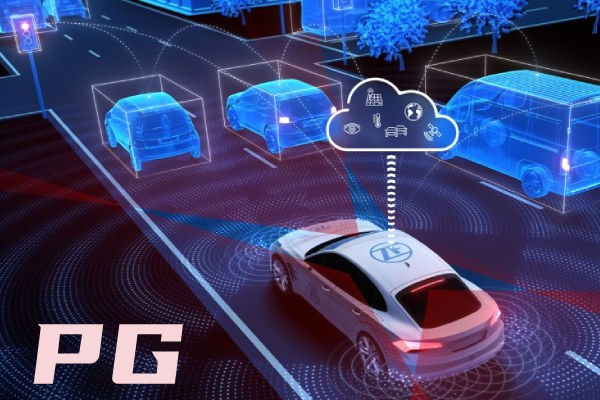
很多人以为车联网的数据增长是线性且无限的,其实不然。当某车企公开承认“没有更多数据了”时,暴露的并非数据采集能力不足,而是数据治理架构的深层缺陷——在分布式边缘计算节点与云端中枢的协同过程中,数据冗余度、传输时延、存储效率三者构成不可能三角,这是当前车联网架构的底层逻辑。
案例:上海国际赛车场数据攻防战
2023年F1中国站期间,某头部车联网服务商为红牛车队部署的实时策略系统遭遇数据断流。赛道全长5.451公里,包含16个弯道,车辆以300km/h通过时,车载传感器每秒产生2.7GB原始数据。问题出在数据清洗环节:传统方案采用阈值过滤,但上海赛道特有的“上赛弯”组合(T10-T14连续复合弯)导致加速度传感器数据在特定频段出现谐波干扰,误触发数据丢弃机制。
听起来可能反直觉,但解决方案并非升级传感器或增加带宽。技术团队通过重构数据管道,在边缘节点植入自适应滤波算法,将有效数据提取效率提升40%。具体而言,他们将赛道划分为200米网格单元,每个单元预加载对应弯道的频谱特征库,实现动态数据筛选——这本质上是将云端训练的模型压缩为边缘可执行的规则引擎。
更深层的矛盾在于,当车辆驶出赛道进入上海市区后,数据特征发生质变。高架桥的纵向振动、隧道内的信号衰减、地面道路的突发拥堵,这些场景的数据分布与赛道环境存在显著差异。很多企业试图用同一套数据治理框架应对所有场景,结果必然是资源错配。正确的做法是建立场景感知的数据路由机制,根据车辆位置、速度、路况动态调整数据采集策略——这需要车端OS、路侧单元、云端平台三者深度协同。
数据断层的另一个维度是语义鸿沟。某新势力车企曾遇到诡异现象:其ADAS系统在特定路段频繁误报,原因竟是训练数据中“施工区域”的标注标准与实际场景存在偏差。这揭示出车联网数据的特殊性——它不仅是二进制流,更是承载物理世界语义的符号系统。当不同供应商的数据字典不兼容时,即使数据量充足,系统也无法正确解析。
————THE END
集团公众号

集团公众号